自分で時間をかけて書いた記事が、AIの学習に使われる。AIがその内容を読者に要約して、元の記事は開かれないかもしれない。一方で、AI検索から自分の記事を見つけてもらえる可能性もあります。
Webサイトを運営する立場で考えると、AIをすべて拒否するか、すべて許可するかの二択では整理できません。
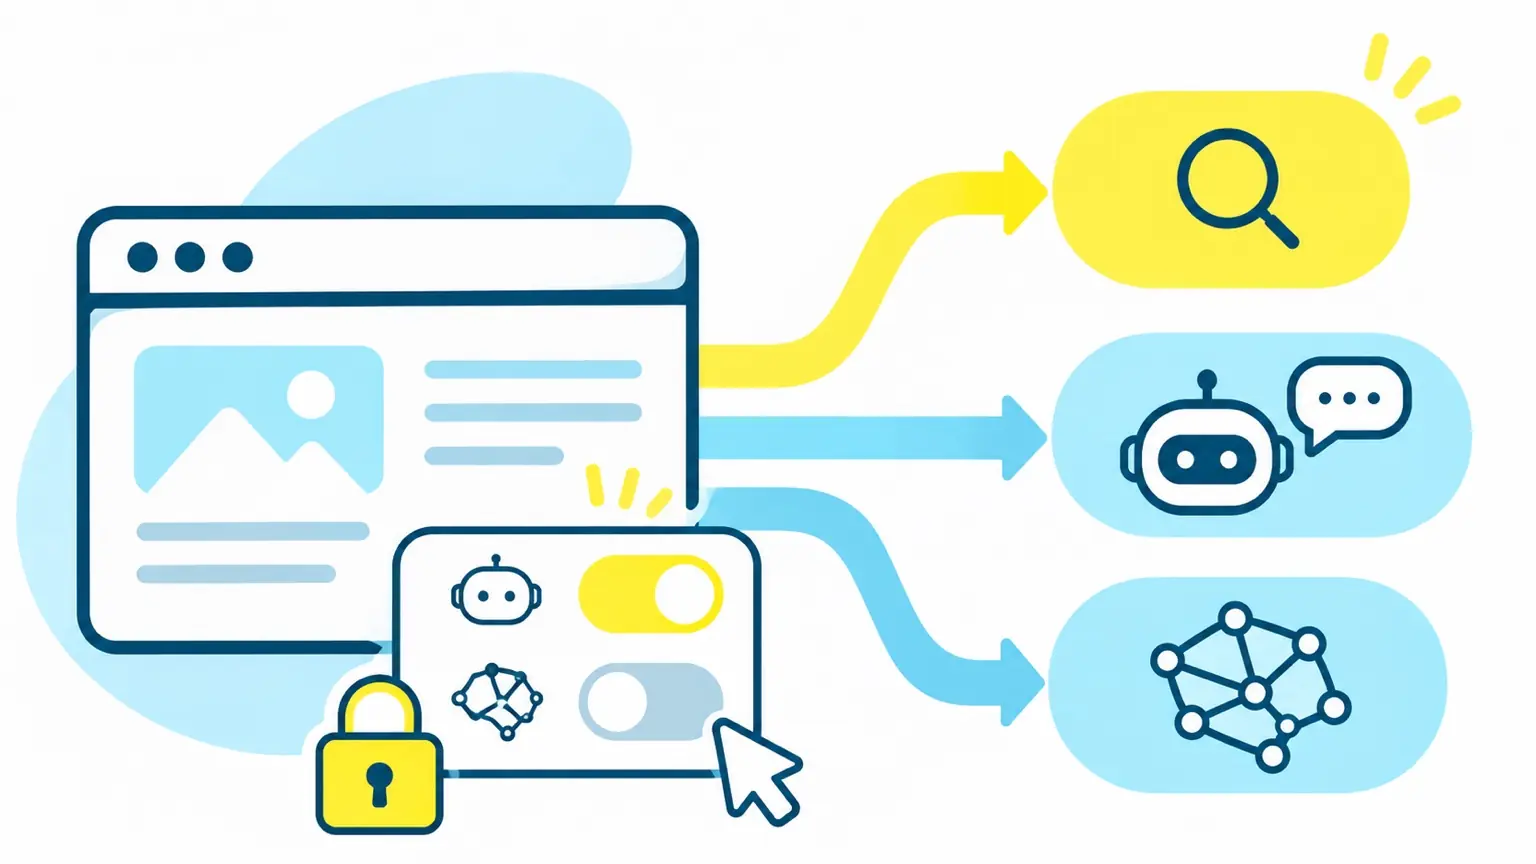
2026年10月30日、OpenAIは複数のAI事業者に共通して学習利用の意向を伝える仕組みを支持すると発表しました。ただし、この共通信号へのOpenAIの対応は今後数か月以内を目指す段階です。今回の発表は、サイトの設定を今すぐ変えるためのニュースというより、公開した記事を誰に、どの目的で使ってもらいたいかを考え直す機会だと思います。
「読んでもらう」と「学習に使われる」は同じではない
最初に分けたいのは、次の3つです。
| 用途 | 何が起こる? | 運営者が考えたいこと |
|---|---|---|
| 通常の検索 | 検索結果から読者が記事に訪れる | 見つけてもらいやすさ |
| AI検索・回答での参照 | AIが記事を探し、回答の根拠に使う | 出典表示と読者の流入 |
| 基盤モデルの学習 | 記事がモデルの訓練に利用される | 作品・知識の利用条件 |
これらは別の用途ですが、技術的には一部のクローラーや仕組みが重なります。「AI学習を拒否すれば、AI検索への表示はそのまま維持できる」と、すべてのサービスについて断言することもできません。
AI検索で紹介されることは、記事が読まれることなのか
AIが質問に直接答えられるようになるほど、読者は元のページを開かずに満足するかもしれません。検索結果に出典リンクが表示されれば新しい読者との接点になりますが、必ずクリックされるわけではありません。
一方、型紙の補正やiPadの設定のように、写真、図解、実際の手順まで必要な記事は、短いAIの要約だけでは代わりになりにくいはずです。
だからこそ、AI検索で発見されることを目指すなら、単なるニュースの言い換えよりも、自分で試した工程、失敗と修正、判断した理由を残す価値が高くなります。検索結果の表示形式を追いかけるだけでなく、読者がページを開く理由を作ることが重要です。
ChatGPTの検索系クエリはGoogleの約5分の1という推計
2026年11月3日、OpenAIのChatGPTコンシューマープロダクト責任者Adam Fry氏は、ChatGPTでの「検索に相当する質問」の件数が、Googleの検索件数のおよそ5分の1に達したと説明しました。米メディア「Big Technology」のインタビューで語ったもので、ChatGPTの利用が文章作成やプログラミングから、人や場所、商品などの情報探しへ広がっていることを示す数字です。
ただし、これはOpenAI側による検索件数の比較です。Fry氏の説明では、質問に応じてウェブ検索が行われるたびに1件と数えます。Google側の比較対象となる件数や集計期間・方法の詳細は示されていません。したがって、「Google検索の20%がChatGPTに移った」「検索市場の20%を獲得した」という意味にはなりません。同じ人が両方を使うこともありますし、AIが出典リンクを表示した回数や、そのリンクから記事が読まれた回数を示す数字でもありません。
なお、ChatGPTの週間利用者数「12億人」は2026年9月29日のOpenAI公式発表にすでに登場しています。今回初めて12億人に到達したわけではありません。
個人のWebサイトにとって大事なのは、検索する場所が増えたことと、記事まで訪問してもらえることを分けて考えることです。GoogleもAI検索向けに特殊な構造化データを追加する必要はないと案内しています。まずは通常の検索で見つかる基本的な整備を続けつつ、AIの短い回答だけでは伝わらない独自の写真・比較・検証過程を記事に残していきたいところです。
この発言の詳しい背景や数字の捉え方、個人ブログ・発信への影響については、以下の記事で整理しています。
ニュース
ChatGPTの検索件数はGoogleの約5分の1?数字の本当の意味と、個人ブログ・発信への影響
OpenAI幹部が明かした「ChatGPTの検索クエリ数はGoogleの約20%」という発言。市場シェアとの違いや、AI検索が広がる中で個人のWeb発信で大切にしたいことを整理しました。
記事を読む →robots.txtでできること、できないこと
robots.txtは、クローラーにサイトの巡回方針を伝えるためのファイルです。OpenAIは学習向けのGPTBotと検索向けのOAI-SearchBotを区別して案内しています。GoogleのGoogle-Extendedも、Google検索への掲載とは別にAI関連の利用を制御するためのトークンです。
ただし、robots.txtはアクセスを物理的に防ぐ認証機能ではありません。規則に従わないクローラーへの強制力はなく、著作権の許諾条件や法的な判断をこれだけで確定できるわけでもありません。
OpenAIが支持した新しい共通信号も、参加する事業者に意向を伝える仕組みです。すべてのAI企業に同じ効果が及ぶわけではなく、現時点で既存の設定を急いで書き換える理由にはなりません。
小さなメディアなら、何を基準に決める?
例えばiPadの新機能を紹介する記事と、何週間もかけて検証した独自の制作ノウハウでは、AIによる利用への感じ方が違うかもしれません。
自分なら、まず次の順番で考えます。
- 誰に読んでほしいか。 検索から初めて来る人か、ニュースレターの読者か、制作の手順を学びたい人か。
- 何を公開しているか。 一次資料の整理か、自分の試行錯誤か、有料コンテンツの一部か。
- どこまでAIに使ってほしいか。 発見のための参照と、学習データとしての利用を同じ扱いにする必要があるか。
- 結果をどう確かめるか。 検索流入、参照元、読者の反応など、確認できる指標は何か。
有料ニュースレターや販売コンテンツについては、公開ページのクローラー設定とは別に、公開範囲とアクセス制御も確認する必要があります。
いま実際に確認しておきたいこと
サイト運営者として最初にできるのは、設定変更よりも現状把握です。
robots.txtにどのクローラー向けの規則があるかsitemap.xmlが公開記事を適切に案内しているか- AI学習向けとAI検索向けの扱いが意図どおりか
- 独自の取材・実践・検証を含む記事が、読者にとって十分な価値を持っているか
設定を変更する場合は、変更前の内容をGitで残し、何を目的に変えたのかを記録しておくと、後から検証できます。
AIに使わせないことより、何を届けたいかから考える
Webサイトを公開するのは、情報を誰かに届けたいからです。しかし、公開しているからといって、あらゆる用途への利用を無条件で受け入れたいとは限りません。
AIに見つけてもらうことも、記事の価値を守ることも、どちらか一方だけを選ぶ必要はないはずです。今後は技術的な制御が整うのを待ちながら、自分のサイトにとって大切なものを先に言葉にしておくことが、運営方針を決める助けになります。
参考資料
- OpenAI:AI学習への利用意向をウェブサイトが伝えやすくする仕組み(2026年10月30日)
- OpenAI:クローラーの概要
- Google:GoogleのクローラーとGoogle-Extended
- Google:robots.txtの仕組み
- Big Technology:OpenAI幹部インタビュー(2026年11月3日)
- OpenAI:DevDay 2026 Recap(2026年9月29日)
- Google検索セントラル:AI機能とウェブサイト
関連記事
記事
ChatGPTの音声会話がプラグインに対応|iPadで話して始め、画面で仕上げる
ChatGPTのLive音声会話はプラグインに対応しています。通常のChatでも音声から連携アプリを操作でき、通話後のテキストで続きを進められます。画面承認の仕組みやiPadでの活用法を整理します。
記事を読む →
ニュース
Adobe、Creative CloudにAIエージェントとローカルMCP連携|制作アプリを外部AIから操作へ
Adobe MAX 2026で発表されたCreative Agentの拡張とローカルMCP連携。Photoshop、Illustrator、Premiere、After Effectsを外部AIから操作する構想と提供時期を整理。
記事を読む →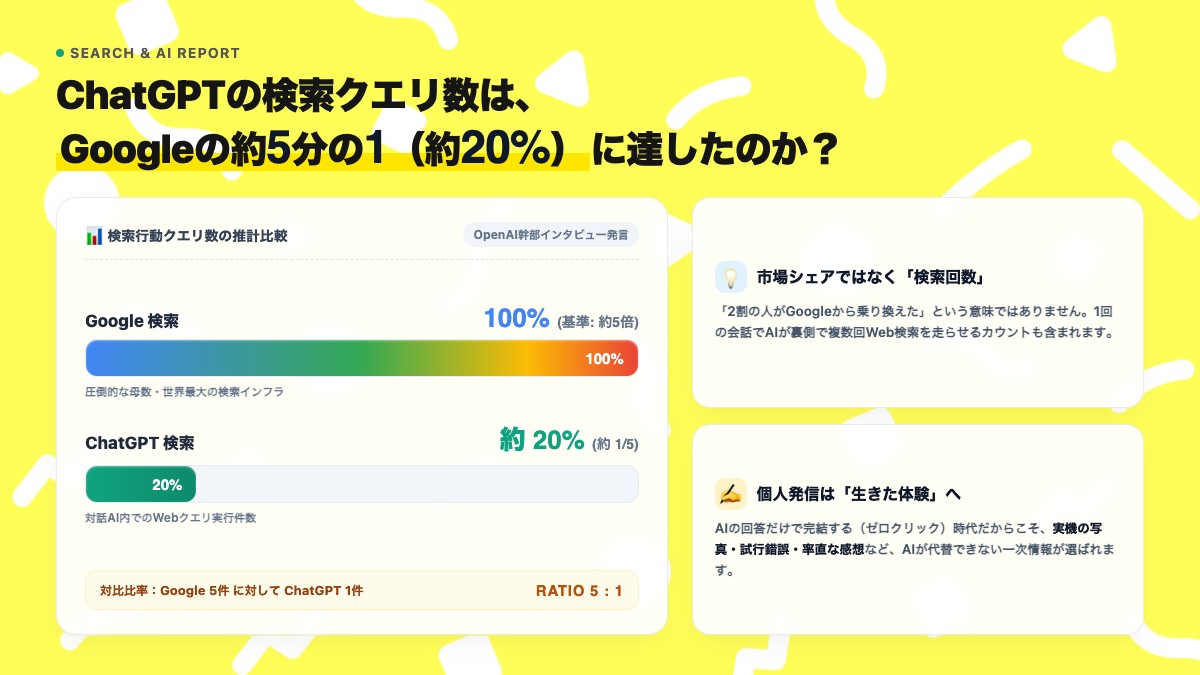
ニュース
ChatGPTの検索件数はGoogleの約5分の1?数字の本当の意味と、個人ブログ・発信への影響
OpenAI幹部が明かした「ChatGPTの検索クエリ数はGoogleの約20%」という発言。市場シェアとの違いや、AI検索が広がる中で個人のWeb発信で大切にしたいことを整理しました。
記事を読む →
新機能
ChatGPTで動くGIFが作れるように|言葉や写真から短いアニメーションを生成する新機能
ChatGPTで文章や写真からアニメーションGIFを作れる新機能が順次展開中。日本語アプリでの案内画面、動画とは違うGIFならではの使いどころやiPadでの活用イメージをまとめました。
記事を読む →